あるとき、統計分析のため、
重みに応じたリサンプリングをする必要ができました。
floatのベクトルvがあったとすると
p=v/sum(v)
を確率ベクトルとして、復元抽出するコードを考えてみました。
探しては見たのですが、すぐには見つかりませんでした。
そこで、したのような処理で実現してみました。
import numpy as np
n = 100
def resamp( v, n ):
vsum = np.sum(v)
vcum = np.cumsum(v)
indices = np.array([ np.argmax(1.0/(vcum - r)) for r in np.random.uniform(0,vsum,n) ])
return indices
確率ベクトルvと出力サンプル数nを入力し、インデックスのnumpy.arrayを返す関数です。
備忘録のため、ブログに載せてみましたが、
関数一つでできる方法がないのだろうか。

2015年11月14日土曜日
python 科学計算関係のライブラリWindows版
pythonは多くのライブラリをimportすることが多いです。
一つのことをするにしてもnumpyやscipy、またグラフを描くならmatplotlibとか。
PIPがうまく動作しない場合も多く、Windowsの場合インストーラを使わなければならないばあいが多いような気がします。 Linuxなら該当するパッケージ名さえわかれば、aptとpipでたいてい何とかなります。 Linxuの場合の話はまた今度します。
それぞれ、pipやeasy_installでインストールできるものもあれば、できないものもありややこしいので、現状でのインストール方法をまとめてみました(2015年10月現在)。
numpyやscipyはeasy_installやpipを使うとlapackなどのライブラリと接続できないなどというエラーがでて面倒なので、おとなしくサイトからsuperpackというものをダウンロードしてインストールしました。
ウィンドウズでバイナリをダウンロードしてくる場合はpythonのバージョン、32/64ビットの違いに注意してください。
pandasはeasy_installでうまくいかず、pipでインストールできました。 なぜかeasy_installではvcvarsall.batが無いと怒られます。そのときのエラーをコピペしておきます。
 UPDATING build\lib.win32-2.7\pandas/_version.py
 set build\lib.win32-2.7\pandas/_version.py to '0.17.0'
 error: Setup script exited with error: Unable to find vcvarsall.bat
統計分析のstatsmodelsはeasy_installでインストールしました。
ただし、scipyやpandas、patsyを使っているようなので、それぞれをインストールしてからにしましょう。
patsyはpipでできました。
そのほかにもいくつか科学技術計算ライブラリがありますが、 長くなりそうなので、残りはまた今度ご紹介します。
2014年11月8日土曜日
ラン ダム文字列生成
ご無沙汰しております。
最近仕事で、任意の長さのランダム文字列を生成するスクリプトを作りました。
CGIなどでセッション情報などをpythonで管理する場合、重複する可能性の低いランダムな文字列が必要になることがあります。
それで、英数字大小文字混合の26+26+10=62種類をまぜて任意の長さの文字列を作ります。
下のソースが作成したスクリプトです。
import string
import numpy
m=100
s = ''.join(numpy.random.choice( list( string.digits + string.letters ), m ))
print s
pythonはたくさんのライブラリがあって便利な反面、簡単なことをするにしても、ライブラリを複数読み込む必要があります。
今回もnumpyとstringを読み込んでいます。
numpyは以前も説明した通り、python標準ではありませんので、別にインストールする必要があります。
ポイントとしては
listで文字列をリストに変換しているところと、
numpy.random.choiceで配列要素から100個サンプリングしているところです。
string.lettersは'abcd.....'というようなすべての英数字を含んだ文字列が欲しかったので使いました。
もちろん、他の方法でもできますが、これが一番理解しやすくて簡潔だと思います。
是非使ってみてください。
2014年6月23日月曜日
OpenCV 4
Contourとは等高線を指しますが、輪郭という意味もあります。
OpenCVではcontourを輪郭情報という意味で使用しています。
cv2の中にはfindContoursというcontourを計算する関数があります。
つまり、画像から輪郭を抽出することができます。
たとえば、
ret, thresh = cv2.threshold( imgray, 127, 255, 0 )
c = cv2.findContours( thresh, cv2.RETR_TREE, cv2.CHAIN_APPROX_SIMPLE )
とすることによりimgrayの画像を閾値処理して輪郭抽出します。
ただし、imgrayというのは2値化された画像で、通常のカラー画像を入れるとエラーになります。
カラー画像imを2値画像gimに変換する場合は、
gim = cv2.cvtColor( im, cv2.cv.CV_BGR2GRAY )
とします。
contourを描画する場合、
cv2.drawContours( im, c, -1, (0,255,0), 3 )
とすると緑色で輪郭情報cを画像imに描画します。
輪郭情報を最小の長方形領域に納める場合
x,y,w,h = cv2.boundingRect(c)
とします。
この長方形領域は
cv2.rectangle(im,(x,y),(x+w,y+h),(0,255,0),2)
とすることによって描画できます。
以上を踏まえて、
WEBカメラから取得した画像から輪郭を抽出して描画するプログラムを作ってみました。
ENTERキーを押すと終了します。
import cv2
import numpy as nmp
cv2.namedWindow('CAMERA')
v = cv2.VideoCapture(0)
v.grab()
im = v.read()
### to binary
gim = cv2.cvtColor( im[1], cv2.cv.CV_BGR2GRAY )
### thresholded
ret, thresh = cv2.threshold( gim, 127, 255, 0 )
c = cv2.findContours( thresh, cv2.RETR_TREE, cv2.CHAIN_APPROX_SIMPLE )
for i, cc in enumerate(c[0]):
cv2.drawContours( im[1], cc, -1, (50*i/255,255,i%255), 3 )
print '%d,255,%d' % ( 20*i/255, i%255)
cv2.imshow( 'CAMERA', im[1] )
cv2.waitKey(0)
ラボの画像から輪郭抽出してみました。

たくさんの小さい輪郭ができてしまいました。
実際に使う場合は、いかにして目的とするものの輪郭を計算するかという工夫が重要だと思います。
OpenCVではcontourを輪郭情報という意味で使用しています。
cv2の中にはfindContoursというcontourを計算する関数があります。
つまり、画像から輪郭を抽出することができます。
たとえば、
ret, thresh = cv2.threshold( imgray, 127, 255, 0 )
c = cv2.findContours( thresh, cv2.RETR_TREE, cv2.CHAIN_APPROX_SIMPLE )
とすることによりimgrayの画像を閾値処理して輪郭抽出します。
ただし、imgrayというのは2値化された画像で、通常のカラー画像を入れるとエラーになります。
カラー画像imを2値画像gimに変換する場合は、
gim = cv2.cvtColor( im, cv2.cv.CV_BGR2GRAY )
とします。
contourを描画する場合、
cv2.drawContours( im, c, -1, (0,255,0), 3 )
とすると緑色で輪郭情報cを画像imに描画します。
輪郭情報を最小の長方形領域に納める場合
x,y,w,h = cv2.boundingRect(c)
とします。
この長方形領域は
cv2.rectangle(im,(x,y),(x+w,y+h),(0,255,0),2)
とすることによって描画できます。
以上を踏まえて、
WEBカメラから取得した画像から輪郭を抽出して描画するプログラムを作ってみました。
ENTERキーを押すと終了します。
import cv2
import numpy as nmp
cv2.namedWindow('CAMERA')
v = cv2.VideoCapture(0)
v.grab()
im = v.read()
### to binary
gim = cv2.cvtColor( im[1], cv2.cv.CV_BGR2GRAY )
### thresholded
ret, thresh = cv2.threshold( gim, 127, 255, 0 )
c = cv2.findContours( thresh, cv2.RETR_TREE, cv2.CHAIN_APPROX_SIMPLE )
for i, cc in enumerate(c[0]):
cv2.drawContours( im[1], cc, -1, (50*i/255,255,i%255), 3 )
print '%d,255,%d' % ( 20*i/255, i%255)
cv2.imshow( 'CAMERA', im[1] )
cv2.waitKey(0)
ラボの画像から輪郭抽出してみました。
たくさんの小さい輪郭ができてしまいました。
実際に使う場合は、いかにして目的とするものの輪郭を計算するかという工夫が重要だと思います。
2014年6月9日月曜日
フラクタル 第4回
フラクタルシリーズの4回めです。
今回も、マンデルブロのアレンジを作ってみました。
ただ、毎回関数を別に作るのは無駄なので、P乗で一般化してみました。
つまり、
z(n+1) = z(n)**p + c
z(0)=0
とした時のcと最終のzの値を出力します。
import numpy as np
def makeMandelbrotP( itrn, p=2, n=100, xrange=None, yrange=None ):
if xrange == None:
xrange = (-2.5, 2.5)
if yrange == None:
yrange = (-2.5, 2.5)
r = np.random.uniform( xrange[0], xrange[1], n) + 1j*np.random.uniform( yrange[0], yrange[1],n)
c = r.copy()
z = 0
for i in range(itrn):
z = z**p + c
return c, z
今回はp=4として4乗にした時、このzの値が発散しているかどうかを複素平面上に表示しました。

予想通り、120度の回転対称です。
前回の3乗で180度対称だったので、p乗で306/(p-1) 度の回転対称になるものと想像できます。
この図は16回の繰り返しです。
繰り返し回数については、8回ぐらいでだいたいフラクタルっぽくなります。


一枚あたりのデータ量が多く、リスト内表記を使うとメモリアロケーションのエラーになるので、
仕方なくforループを使いました。
通常書類作成用に使っているPC(Core2Quad 2.4GHz)で、上の画像作成時間は一枚あたり6分位かかりました。
今回も、マンデルブロのアレンジを作ってみました。
ただ、毎回関数を別に作るのは無駄なので、P乗で一般化してみました。
つまり、
z(n+1) = z(n)**p + c
z(0)=0
とした時のcと最終のzの値を出力します。
import numpy as np
def makeMandelbrotP( itrn, p=2, n=100, xrange=None, yrange=None ):
if xrange == None:
xrange = (-2.5, 2.5)
if yrange == None:
yrange = (-2.5, 2.5)
r = np.random.uniform( xrange[0], xrange[1], n) + 1j*np.random.uniform( yrange[0], yrange[1],n)
c = r.copy()
z = 0
for i in range(itrn):
z = z**p + c
return c, z
今回はp=4として4乗にした時、このzの値が発散しているかどうかを複素平面上に表示しました。
前回の3乗で180度対称だったので、p乗で306/(p-1) 度の回転対称になるものと想像できます。
この図は16回の繰り返しです。
繰り返し回数については、8回ぐらいでだいたいフラクタルっぽくなります。
繰り返し2回
繰り返し3回
繰り返し4回
繰り返し5回
繰り返し6回
繰り返し7回
繰り返し8回
という感じです。一枚あたりのデータ量が多く、リスト内表記を使うとメモリアロケーションのエラーになるので、
仕方なくforループを使いました。
通常書類作成用に使っているPC(Core2Quad 2.4GHz)で、上の画像作成時間は一枚あたり6分位かかりました。
2014年5月21日水曜日
bool
ブール型の演算について
どの言語もそうですが、整数型や浮動小数点型の演算はだいたい同じですが、ブール型の演算は少しずつやり方が異なっているような気がします。
pythonでの扱い方について記録しておきます。
a = True
b = False
a and b
とすると
False
となります。
a+b
とすると
1
となり、
a+a
とすると
2
になります。
つまり、ブール型はTrueが1、Falseが0の値になっていると考えて構わないと思います。
それで、今度はnumpy.arrayでの扱いです。
aa = numpy.array( [ a, a, b] )
とすると
array([ True, True, False], dtype=bool)
となり、bool型として扱われていることがわかります。
で、今度は
aa and aa
とするとエラーになります。
実行した結果のエラーメッセージは下のようになっていました。
Traceback (most recent call last):
File "<stdin>", line 1, in <module>
ValueError: The truth value of an array with more than one element is ambiguous.
Use a.any() or a.all()
numpy.arrayは他の型ではそれぞれの要素に関して個別に演算するので、ブール型もそうかと思うとそうでもないようです。
で、今度は
aa = numpy.array( [True, True, False], dtype=bool)
bb = numpy.array( [False, True, False], dtype=bool)
aa + bb
aa * bb
とすると、それぞれ下のようになりました。
>>> aa+bb
array([ True, True, False], dtype=bool)
>>> aa*bb
array([False, True, False], dtype=bool)
つまり、要素個別に演算する場合は+と*でandとorの代用する必要があるということです。
andとor,notは単独のTrue, Falseといったブール値にしか使えません。
notで実現していた、反転をさせる場合はどうするかというと、
~aa
とします。
結果は
array([False, False, True], dtype=bool)
となります。
ブールのarrayは結構有用です。
たとえば、
x = numpy.random.randint( 0, 10, 12 )
c = x>5
print x[c]
というように、条件にあったものだけ抽出する際に使います。
cは
array([ True, False, True, False, True, False, True, True, True,
False, False, False], dtype=bool)
といった風にbool型のarrayになっています。
2014年5月12日月曜日
フラクタル
pythonで複素数の練習を兼ねて
フラクタル図形を作ってみました。
マンデルブロ集合というものです。
フラクタルが何かについては専門書または他のサイトなどで調べてみてください。
マンデルブロ集合の定義は簡単な複素数漸化式で記述されます。
つまりマンデルブロ図形というのはある複素数cについて、
z(n+1) = z(n)*z(n) + c
z(0) = 0
とした場合、n→∞で発散するか否かを色分けして複素平面に表示したものです。
複素数平面の点をランダムに選び、n回漸化式を解いてz(n)を作ります。
その時の、
log |z(n)|
の値を画素の輝度値としました。
forループを2重に使うと時間がかかるので、numpy.arrayで一気に計算します。
m = 10000
c = numpy.random.uniform( -2.5,2.5,m ) + 1j * numpy.random.uniform( -2.5,2.5,m )
z = numpy.zeros( m, dtype=numpy.complex )
for i in range(16):
z = z**2 + c
と言う感じです。
opencvを使って画像化します。
しかし、案外時間が掛かるので、zの漸化式計算と、画像化を分けて処理しました。

30Mポイントのサンプリングをして、そこから画像化しましたが、埋め切れていません。画像を拡大してみるとポツポツと黒い点が見えます。
実は細くつながっています。が、データ点数(サンプリング)で埋め切れていないのと画像化の解像度が荒いため、つながっているようには見えません。
フラクタル図形を作ってみました。
マンデルブロ集合というものです。
フラクタルが何かについては専門書または他のサイトなどで調べてみてください。
マンデルブロ集合の定義は簡単な複素数漸化式で記述されます。
つまりマンデルブロ図形というのはある複素数cについて、
z(n+1) = z(n)*z(n) + c
z(0) = 0
とした場合、n→∞で発散するか否かを色分けして複素平面に表示したものです。
複素数平面の点をランダムに選び、n回漸化式を解いてz(n)を作ります。
その時の、
log |z(n)|
の値を画素の輝度値としました。
forループを2重に使うと時間がかかるので、numpy.arrayで一気に計算します。
m = 10000
c = numpy.random.uniform( -2.5,2.5,m ) + 1j * numpy.random.uniform( -2.5,2.5,m )
z = numpy.zeros( m, dtype=numpy.complex )
for i in range(16):
z = z**2 + c
と言う感じです。
opencvを使って画像化します。
しかし、案外時間が掛かるので、zの漸化式計算と、画像化を分けて処理しました。
Mandelbrot set
30Mポイントのサンプリングをして、そこから画像化しましたが、埋め切れていません。画像を拡大してみるとポツポツと黒い点が見えます。
実は細くつながっています。が、データ点数(サンプリング)で埋め切れていないのと画像化の解像度が荒いため、つながっているようには見えません。
2014年5月9日金曜日
複素数
python numpyでの複素数の扱い方についてです。
複素数は型としてはnumpy.complexと定義されています。
これを利用してみます。
つまり、
numpy.array( [3, 2, 1], dtype=numpy.complex )
とすると
array([ 3.+0.j, 2.+0.j, 1.+0.j])
というふうに複素数配列となります。
複素数の演算もできます
a = numpy.array( [3, 2, 1], dtype=numpy.complex )
複素数は型としてはnumpy.complexと定義されています。
これを利用してみます。
つまり、
numpy.array( [3, 2, 1], dtype=numpy.complex )
とすると
array([ 3.+0.j, 2.+0.j, 1.+0.j])
というふうに複素数配列となります。
複素数の演算もできます
a = numpy.array( [3, 2, 1], dtype=numpy.complex )
a ** 2
とすると2乗します。
実行結果は
array([ 9.+0.j, 4.+0.j, 1.+0.j])
となります。
指数計算はそのまま掛けて計算されます。
つまり、python風な数式で表すと
z=x+jy
とすると
z**2 = (x+jy) * (x+jy) = x**2 - y**2 + j 2*x*y
となります。
複素数には色々と実数にはなかった計算方式が出てくるので注意が必要です。
実数部は
numpy.real(z)
虚数部は
numpy.imag(z)
とします。
これらの関数はzがarrayでもOKです。その場合、出力もarrayになります。
複素共役は
numpy.conj(z)
とします。
複素共役が何かわからない場合は検索してみて下さい。
誰かがわかりやすく説明してくれていると思います。
絶対値はnumpy.abs(z)
で計算できます。
複素数の乱数発生は簡単にはできませんでした。
一様分布の場合
z = numpy.random.uniform( -5, 5, 10 ) + 1j * numpy.random.uniform( -5, 5, 10 )
としました。
結果は
array([-4.48658518-4.19169279j, 2.39542899+4.87030019j,
4.03412469-1.00727465j, 1.72313031+0.99345025j,
0.68053779-0.385337j , 2.08333535-0.32240792j,
-0.65638447-0.27364433j, 1.36415791-1.89435328j,
0.19786534-4.51657661j, 2.44853396+3.04850488j])
となりました。
もっとスマートな方法があれば、是非ご教示下さい。
2014年4月25日金曜日
arrayデータの16進パターン
numpyのarrayにはいくつかのメソッドがあります。
覚えておくとたまに便利になる機能がいくつかあります。
まず、tostringです。
動作確認しつつまとめてみます。
tostringメソッドは文字通り、arrayのデータをstringデータとして出力します。
数値を文字列に変換するわけではありません。
どういうときに使用するかというと、場合それぞれですが、
たとえば、シリアル通信やTCP/IP通信などで文字列として受け取ったデータを、数値として扱いたい場合などに使えます。
最近では、画像データの変換として使いました。
例を挙げます。
そこで、x
つまり、arangeで作成した段階で、4[byte](32bit)のint型として扱われ、リトルエンディアン方式で保管されているようです。
これを文字列として保存して、arrayとして戻すためには、
浮動小数点の場合はdtypeをfloatに指定します。
その他、32bitや64bit、または整数型か浮動小数点型か、符号有無などの細かい設定が必要な場合は、numpyの下に定義されている型を利用します。
たとえば
符号無整数
numpy.uint8
numpy.uint16
numpy.uint32
numpy.uint64
符号付整数
numpy.int8
numpy.int16
numpy.int32
numpy.int64
浮動小数点
numpy.float16
numpy.float32
...
複素数
numpy.complex
numpy.complex64
...
などです。
ちなみに、数値データをそれぞれ文字列に変換する場合は、いくつか方法がありますが、
listとして出力するなら
今度、それぞれの方法について処理時間などの比較をしてみます。
例で使用したnumpyは1.8.1 (python 2.6)を使用しています。
覚えておくとたまに便利になる機能がいくつかあります。
まず、tostringです。
動作確認しつつまとめてみます。
数値を文字列に変換するわけではありません。
どういうときに使用するかというと、場合それぞれですが、
たとえば、シリアル通信やTCP/IP通信などで文字列として受け取ったデータを、数値として扱いたい場合などに使えます。
最近では、画像データの変換として使いました。
例を挙げます。
import numpyとするとxの中身は
x = numpy.arange(-3,3)
array([-3, -2, -1, 0, 1, 2])となります。
そこで、x
s = x.tostring()とすると、sの中身は
'\xfd\xff\xff\xff\xfe\xff\xff\xff\xff\xff\xff\xff\x00\x00\x00\x00\x01\x00\x00\x00\x02\x00\x00\x00'となり、16進のバイナリパターンが文字列として出力されています。
つまり、arangeで作成した段階で、4[byte](32bit)のint型として扱われ、リトルエンディアン方式で保管されているようです。
これを文字列として保存して、arrayとして戻すためには、
numpy.frombuffer( s, dtype=int )とします。結果は、
array([-3, -2, -1, 0, 1, 2])となります。
浮動小数点の場合はdtypeをfloatに指定します。
その他、32bitや64bit、または整数型か浮動小数点型か、符号有無などの細かい設定が必要な場合は、numpyの下に定義されている型を利用します。
たとえば
符号無整数
numpy.uint8
numpy.uint16
numpy.uint32
numpy.uint64
符号付整数
numpy.int8
numpy.int16
numpy.int32
numpy.int64
浮動小数点
numpy.float16
numpy.float32
...
複素数
numpy.complex
numpy.complex64
...
などです。
ちなみに、数値データをそれぞれ文字列に変換する場合は、いくつか方法がありますが、
a.astype( str )とすればできます。
listとして出力するなら
map( str, a )としてもよいかもしれません。
今度、それぞれの方法について処理時間などの比較をしてみます。
例で使用したnumpyは1.8.1 (python 2.6)を使用しています。
2014年4月24日木曜日
数理統計学・データサイエンスとpython
pythonを使って統計アルゴリズムを記述することができます。
現在、統計アルゴリズムをコーディングする上でいくつかの比較的簡便な方法が開発されてきました。統計言語Sを基にしたR言語もその一つです。
ここでは最近急速に発展してきたpythonを使った方法について考察してみます。
最近の流れとしては大規模データ、いわゆるビッグデータの分析に注目が集まっているようです。
pythonはこれまでにも書いてきたようにスクリプト言語で基本インタプリタですので、書き方によっては計算時間がネックになってしまうことがあります。
さらには、もともと統計分析を目的として開発されたSまたはR言語のような機能の豊富さには負けます。
しかし、pythonはそれを上回るほどの開発効率やソースコードの簡潔さが特徴で、ライブラリも多岐にわたるため応用範囲が広いという利点があります。
科学技術計算で使うためのライブラリとしては、有名なものだけでも
- Numpy
- Scipy
- Sklearn
- Pandas
- Jubatus
などがあります。
Numpyについてはこれまでも何回か説明してきましたが、統計に限らず数値演算の基本的な機能を提供します。
Numpyのもっとも重要な機能はArrayだと思います。
Arrayというのはつまり配列ですが、python標準のlistより、ベクトル的な計算を意識したもので、これを効果的に使うことにより、効率的な計算が可能です。
NumpyにはMatrixという型もあります。
Matrixを使うと行列演算が簡単にかけるので便利ではありますが、
Arrayの方が使い勝手が良いと思います。
ScipyはNumpyではカバーしきれなかった科学技術寄りの機能を実現しています。
たとえば、統計アルゴリズムの例でいうと、乱数発生はNumpyの機能が使えます。つまり、
numpy.random.randn(100)
などとすると100個の正規乱数がnumpy.array形式で生成されます。
しかし、正規分布の確率密度関数のグラフが書きたいとなれば、
scipy.statsの機能が使えます。
import numpy
import scipy.stats
p = scipy.stats.norm.pdf( numpy.arange(-3,3,0.1) )
とすれば、pに-3から3までの正規密度関数の値が入ります。
正規分布のほかにもcauchy分布やgammaやvon misesなどの分布もあります。
統計の論文に出てきそうな標準的確率分布はあらかたあります。
残りのライブラリの説明はまた今度します。
興味があれば、それぞれググってみてください。
2014年3月13日木曜日
グラフ
グラフはプレゼンするうえでは必須で、見やすいグラフをどうやって作るかは重要な課題です。
Excelは最近のバージョンで少し見やすくなりましたが、昔はかなりひどいものでした。
これまでMATLABを使ったりRを使ったりしていましたが、
現在は
pythonのグラフ描画ライブラリであるmatplotlibを使っています。
結構グラフがきれいに描画できるのでお勧めです。
import matplotlib.pyplot as ppl
import numpy
t = numpy.arange(100)
ppl.plot( t, numpy.sin( t ) )
ppl.show()

こんな感じで簡単にグラフが描画できます。
行列の値に応じて色分けして表示する場合は、
a = numpy.random.randn(10,15)
ppl.pcolor( a )
とすると表示できます。

Excelは最近のバージョンで少し見やすくなりましたが、昔はかなりひどいものでした。
これまでMATLABを使ったりRを使ったりしていましたが、
現在は
pythonのグラフ描画ライブラリであるmatplotlibを使っています。
結構グラフがきれいに描画できるのでお勧めです。
import matplotlib.pyplot as ppl
import numpy
t = numpy.arange(100)
ppl.plot( t, numpy.sin( t ) )
ppl.show()
こんな感じで簡単にグラフが描画できます。
行列の値に応じて色分けして表示する場合は、
a = numpy.random.randn(10,15)
ppl.pcolor( a )
とすると表示できます。
2014年2月28日金曜日
ctypesによるarrayの受け渡し
計算処理時間がpythonを使っていると問題になることがあります。
pythonはスクリプト言語なので仕方ないといえばそれまでですが、一部分だけでもC言語で書いて実行形式で計算したいと思うことがあります。
ただ、そう思うのが、開発を始めた頃ではなく、開発がほとんど終盤に差し掛かった頃で、移行が簡単ではないことが多いです。
自作class やscipyやnumpyを使い、引数をやりとりしていると、簡単には置き換えしにくくなります。
今回はnumpyのctypesを使ってnumpy.arrayを引数として渡す方法についてまとめてみます。
手順は
という感じです。
1
C言語によるダイナミックリンクライブラリ作成
arrayで渡したい部分は配列にします。
たとえば
double[] hoge( double x[], int n ){
...
}
と言う感じです。
ファイル名はここでは、libhoge.soと言う名前でつくります。
ウィンドウズの場合は拡張子dllにする必要があります。
gccの場合、
gcc -shared hoge.c -o libhoge.so
とします。
2.1 python側
ダイナミックリンク読み込み
dll = numpy.ctypeslib.load_library( 'libhoge.so', '.' )
通常ctypesというライブラリが標準でついているのそちらを使っていますが、numpyのctypeslibはarrayを使うときに便利です。
numpyの場合、実行ディレクトリを指定する必要があります。
2.2. 引数型の設定
ndtype = numpy.ctypeslib.ndpointer( dtype=numpy.float64, ndim=1, flags='C_CONTIGUOUS' )
dll.hoge.argtypes = [ ndtype, numpy.ctypeslib.ct.c_int, ]
2.3.戻り値型指定
dll.hoge.restype = numpy.ctypeslib.ndpointer( dtype=numpy.float64, shape=(100,), flags='C_CONTIGUOUS' )
pythonはスクリプト言語なので仕方ないといえばそれまでですが、一部分だけでもC言語で書いて実行形式で計算したいと思うことがあります。
ただ、そう思うのが、開発を始めた頃ではなく、開発がほとんど終盤に差し掛かった頃で、移行が簡単ではないことが多いです。
自作class やscipyやnumpyを使い、引数をやりとりしていると、簡単には置き換えしにくくなります。
今回はnumpyのctypesを使ってnumpy.arrayを引数として渡す方法についてまとめてみます。
手順は
- c言語でダイナミックリンクライブラリを作ります
- pythonプログラムでライブラリを読み込む設定を書き込みます
- load_libraryで読み込み
- 引数の型設定
- 戻り値の型設定
- テスト
という感じです。
1
C言語によるダイナミックリンクライブラリ作成
arrayで渡したい部分は配列にします。
たとえば
double[] hoge( double x[], int n ){
...
}
と言う感じです。
ファイル名はここでは、libhoge.soと言う名前でつくります。
ウィンドウズの場合は拡張子dllにする必要があります。
gccの場合、
gcc -shared hoge.c -o libhoge.so
とします。
2.1 python側
ダイナミックリンク読み込み
dll = numpy.ctypeslib.load_library( 'libhoge.so', '.' )
通常ctypesというライブラリが標準でついているのそちらを使っていますが、numpyのctypeslibはarrayを使うときに便利です。
numpyの場合、実行ディレクトリを指定する必要があります。
2.2. 引数型の設定
ndtype = numpy.ctypeslib.ndpointer( dtype=numpy.float64, ndim=1, flags='C_CONTIGUOUS' )
dll.hoge.argtypes = [ ndtype, numpy.ctypeslib.ct.c_int, ]
2.3.戻り値型指定
dll.hoge.restype = numpy.ctypeslib.ndpointer( dtype=numpy.float64, shape=(100,), flags='C_CONTIGUOUS' )
2.4 実行テスト
x = dll.hoge( numpy.array([ 0.1, 0.3, 0.5],dtype=float), 3 )
として実行してみます。
これでxがnumpy.arrayになっていればOKです。
2.2や2.3の型の設定がややこしいところです。
2014年2月24日月曜日
確率統計:モンテカルロ
モンテカルロ計算を考えてみます。
統計を含め、科学技術計算には、numpyが使えます。
行列操作ができ、乱数や確率に関するライブラリが豊富です。
numpyは数値計算用のライブラリであり、
中身の逆行列計算などのアルゴリズムはCなどで書かれています。
そのため、うまく書けばpythonとは言えども高速な計算が可能です。
モンテカルロと言うのはモナコにある町の名前です。
計算機科学の世界でいういわゆるモンテカルロ法というのは確率的なサンプリングを行うことによって、計算を行うことを指し、
フォンノイマンによって命名されたと言われています。
今回はnumpyで簡単なモンテカルロ計算を行います。
numpyをまずimportします。
import numpy
中心0分散1の正規乱数を発生させるには、
x = numpy.random.randn(10000)
とします。
同一正規分布に従う二つの独立な変数x1,x2があったとします。
常にx1<x2であるという制約があった場合、この二つはどのような分布となるでしょうか。
x1 = numpy.random.randn(10000)
x2 = numpy.random.randn(10000)
index = x1 < x2
x1とx2をプロットすると

この場合、切断正規分布という分布になります。
こうするとx1とx2は独立ではなくなり、p(x1,x2)と書くと、x1の確率は
p(x1) = ∫p(x1,x2) dX2
となります。
x1とx2のヒストグラムをとるとこんな感じです。
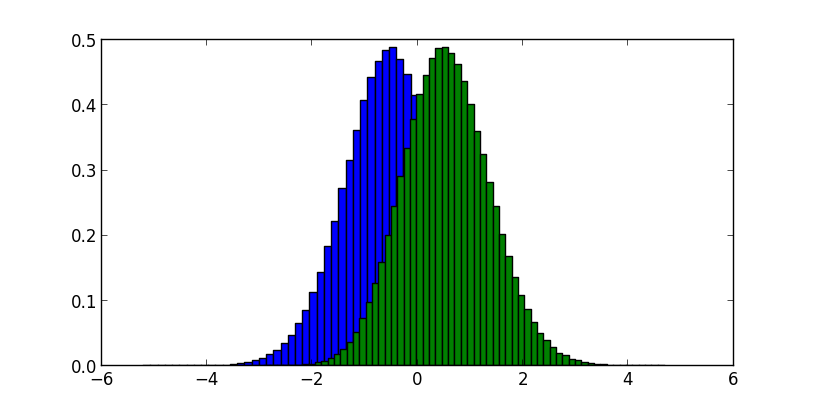
このようにサンプリングを通して、面積や分布などを調べることをモンテカルロ法といいます。
よく円の面積などの例が教科書などに載っていると思います。
モンテカルロは概念が簡単で容易に理解できますが、奥が深いです。
プロットはmatplotlibを使いました。
matplotlibについてはまたそのうちレポートします。
統計を含め、科学技術計算には、numpyが使えます。
行列操作ができ、乱数や確率に関するライブラリが豊富です。
numpyは数値計算用のライブラリであり、
中身の逆行列計算などのアルゴリズムはCなどで書かれています。
そのため、うまく書けばpythonとは言えども高速な計算が可能です。
モンテカルロと言うのはモナコにある町の名前です。
計算機科学の世界でいういわゆるモンテカルロ法というのは確率的なサンプリングを行うことによって、計算を行うことを指し、
フォンノイマンによって命名されたと言われています。
今回はnumpyで簡単なモンテカルロ計算を行います。
numpyをまずimportします。
import numpy
中心0分散1の正規乱数を発生させるには、
x = numpy.random.randn(10000)
とします。
同一正規分布に従う二つの独立な変数x1,x2があったとします。
常にx1<x2であるという制約があった場合、この二つはどのような分布となるでしょうか。
x1 = numpy.random.randn(10000)
x2 = numpy.random.randn(10000)
index = x1 < x2
x1とx2をプロットすると
この場合、切断正規分布という分布になります。
こうするとx1とx2は独立ではなくなり、p(x1,x2)と書くと、x1の確率は
p(x1) = ∫p(x1,x2) dX2
となります。
x1とx2のヒストグラムをとるとこんな感じです。
このようにサンプリングを通して、面積や分布などを調べることをモンテカルロ法といいます。
よく円の面積などの例が教科書などに載っていると思います。
モンテカルロは概念が簡単で容易に理解できますが、奥が深いです。
プロットはmatplotlibを使いました。
matplotlibについてはまたそのうちレポートします。
登録:
投稿 (Atom)